



Ett forskarteam lär sin AI något varje vecka. En expert förklarar varför en metod fallerar bortom en känd gräns. En körning bekräftar vilka inställningar som fungerade. En ny kalibrering ersätter ett gammalt referensvärde. I de flesta konfigurationer fastnar inget av det. Nästa session börjar från det som modellen visste den dag dess träning avslutades, och teamet betalar för samma lärdom igen.
I dag presenterar MatterSpace MS Duplex: självförbättrande agenter för team inom vetenskap och teknik. MS Duplex kopplas in i den AI som dina forskare och ingenjörer redan använder och får den att lära sig medan du arbetar. Varje bekräftat resultat, varje expertkorrigering och varje beslut blir erfarenhet som dina agenter återanvänder, så att varje körning börjar där den förra slutade.
Vad MS Duplex är, och vem den är till för
MS Duplex är det självförbättrande lagret i ett teams vetenskapliga AI. Den finns bredvid de modeller och agenter som du redan kör, och deras vikter lämnas som de är. När ett test går igenom, en mätning kommer tillbaka eller en expert godkänner en slutsats lär sig MS Duplex av det och tillämpar lärdomen från och med nästa begäran, varhelst villkoren passar.
Det är också i MS Duplex som ett teams AI-arbete byggs upp. Bekräftade resultat med sina villkor, korrigeringar med sina skäl, beslut med de belägg de vilade på, verifierade metoder, planer och framsteg i långa kampanjer, och vilka verktyg som fungerade för vilket problem: allt samlas i ett arkiv som din organisation äger. Byt modell, agent eller leverantör, och teamet fortsätter där det slutade.
MS Duplex är utformad och konstruerad för naturvetare, ingenjörer och forskare, och den fungerar inom alla områden. Överallt där ett team kör experiment, simuleringar, analyser eller designgranskningar med AI är loopen densamma. Agenten arbetar genom dina verktyg. Ett test, en mätning eller en expert bekräftar resultatet, eller korrigerar det och säger varför. MS Duplex behåller utfallet med dess belägg. Nästa fall som matchar, i vilken session, agent eller modell som helst, utgår från det.
Den är byggd för de personer som bär det arbetet:
- Ledare inom forskning och teknik som vill att det teamet lär sig ska stanna hos teamet, oavsett vilken modell det kör härnäst.
- Chefer för beräkningsforskning som vill ha färre upprepade körningar och beslut som en annan forskare kan återskapa utifrån historiken.
- Labb- och plattformsansvariga som behöver att teamets regler tillämpas, och att rätt godkännanden ges, innan ett kostsamt steg börjar.
- Forskare och ingenjörer som hellre förklarar ett projekt, och en korrigering, för sin AI en enda gång.
Fjorton förmågor i tre grupper
I MS Duplex fungerar kontinuerlig inlärning, självförbättring, långsiktig planering och forskningsminne som ett enda lager, organiserat kring ditt teams mål. Det finns fjorton förmågor i tre grupper, och var och en gör de andra starkare.
Lära och förbättra
- Kontinuerlig inlärning: lär sig av varje bekräftat resultat från och med nästa begäran och behåller det den lärt sig tidigare intakt.
- Självförbättring: det som fungerade blir det första dina agenter provar, och det som misslyckades slutar att föreslås.
- Återanvändbara metoder: en verifierad procedur tillämpas direkt på nästa liknande fall, och anpassas och föreslås för kontroll i närliggande fall.
- Lära sig orsak och verkan: behåller vilken åtgärd som ledde till vilket utfall, under vilka villkor, och säger när en koppling ännu inte har fastställts.
- Verktygsinlärning: lär sig vilket verktyg, vilken inställning eller vilken metod som presterade väl på vilken typ av problem.
Planera och besluta
- Långsiktig planering: kampanjer som pågår i dagar eller veckor förblir ett enda jobb, med sin plan, sina kontrollpunkter och sina framsteg.
- Simulering före handling: spelar igenom alternativen innan beräkningskapacitet eller labbtid läggs, och sorterar tidigt bort dem som inte kan nå målet.
- Lösa nya problem: sätter ihop ett angreppssätt för ett nytt fall utifrån det som teamet har bekräftat, och kontrollerar det innan någon förlitar sig på det.
- Beslut som känner sina gränser: avgör det som beläggen stöder och lämnar resten till din modell eller en forskare, med skälet.
Minnas och styra
- Forskningsminne: varje session börjar från arbetets nuvarande läge.
- Frihet att byta modell: en ny modell börjar med allt som ditt team har byggt upp.
- Lager för person, team och organisation: vart och ett har sin egen erfarenhet, och dina regler avgör vad som flyttas mellan dem.
- Regler och godkännanden: dina regler kommer först, och de steg du väljer väntar på en person.
- Ursprung, granskning och avinlärning: varje lärdom behåller sin källa, och vilken som helst av dem kan korrigeras eller tas bort för sig.
Grupperna stöder sig på varandra. Ett resultat som bekräftas på måndagen blir en metod. Metoden går in i planen för en lång kampanj. Forskningsminnet för planen vidare till nästa session, reglerna avgör vilka steg som väntar på en person, och ursprunget visar var varje del av den kom ifrån.
- +16 poängmer träffsäker än en modell som finjusterats för uppgiften, i återkommande arbete, utan någon träningskörning
- −89%färre modellanrop än den finjusterade modellen i samma arbete
- 0 av 8 640svar om ett ändrat faktum gav det inaktuella värdet
Alla tre siffrorna kommer från MatterSpaces kontrollerade tester. De två första jämför MS Duplex med en modell som finjusterats för uppgiften, i samma återkommande arbete. Den tredje räknar svar som gavs efter att ett faktum hade ändrats, där AI:n behövde använda det nyare värdet. Finjustering har kvar sin plats när det gäller att ändra vad en modell vet på bred front, och MS Duplex arbetar bredvid en finjusterad modell lika väl som bredvid en generell.
Den kopplas in i den AI som ditt team redan använder
Forskarna och ingenjörerna behåller den AI de känner. MS Duplex ansluter till Claude, Codex, Cursor och andra agenter som talar MCP, den öppna standarden för att ge AI-agenter verktyg. Team som bygger egna forskningsagenter och pipelines lägger till MS Duplex via dess API och Python SDK, med samma inlärning bakom var och en.
Det finns två sätt att ansluta. Med en standardanslutning anropar din agent MS Duplex för att hämta relevant erfarenhet, följa planen och registrera de utfall du tillåter. Det är det snabbaste sättet att komma igång. I miljöer som stöds och har hooks låter en styrd anslutning de steg du väljer passera genom MS Duplex, så att dina regler gäller innan en kostsam simulering eller körning börjar.
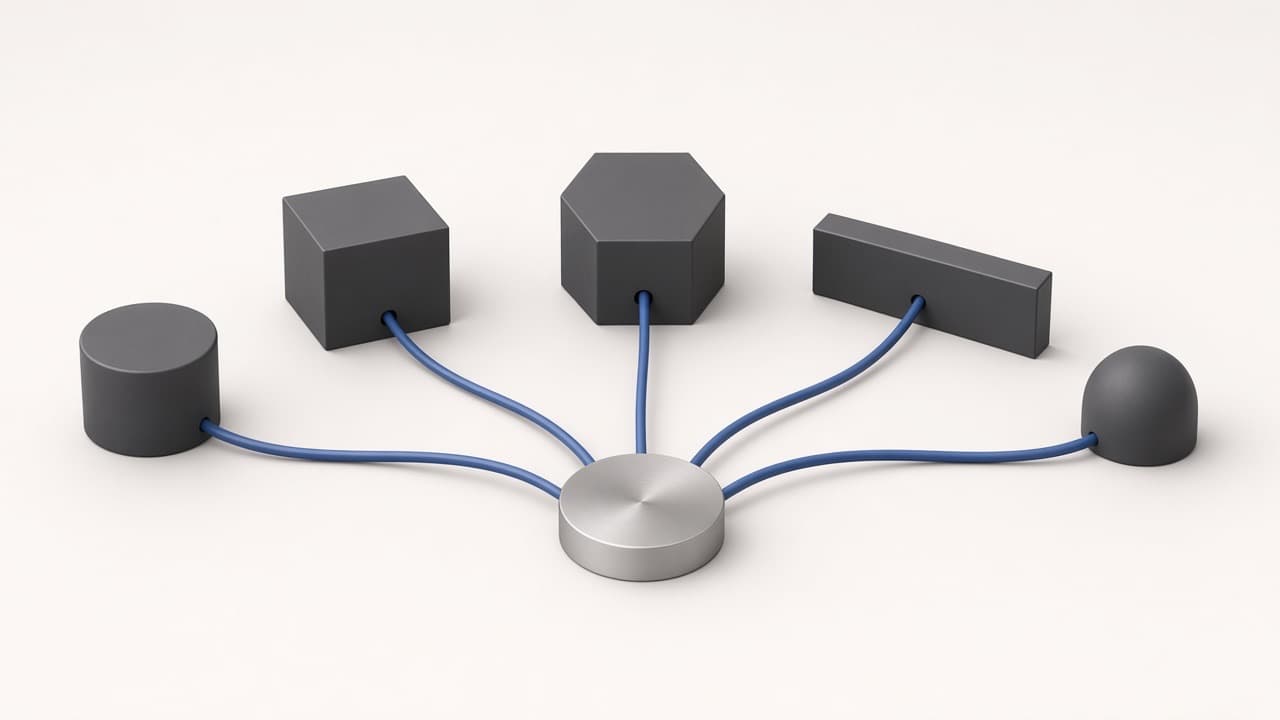
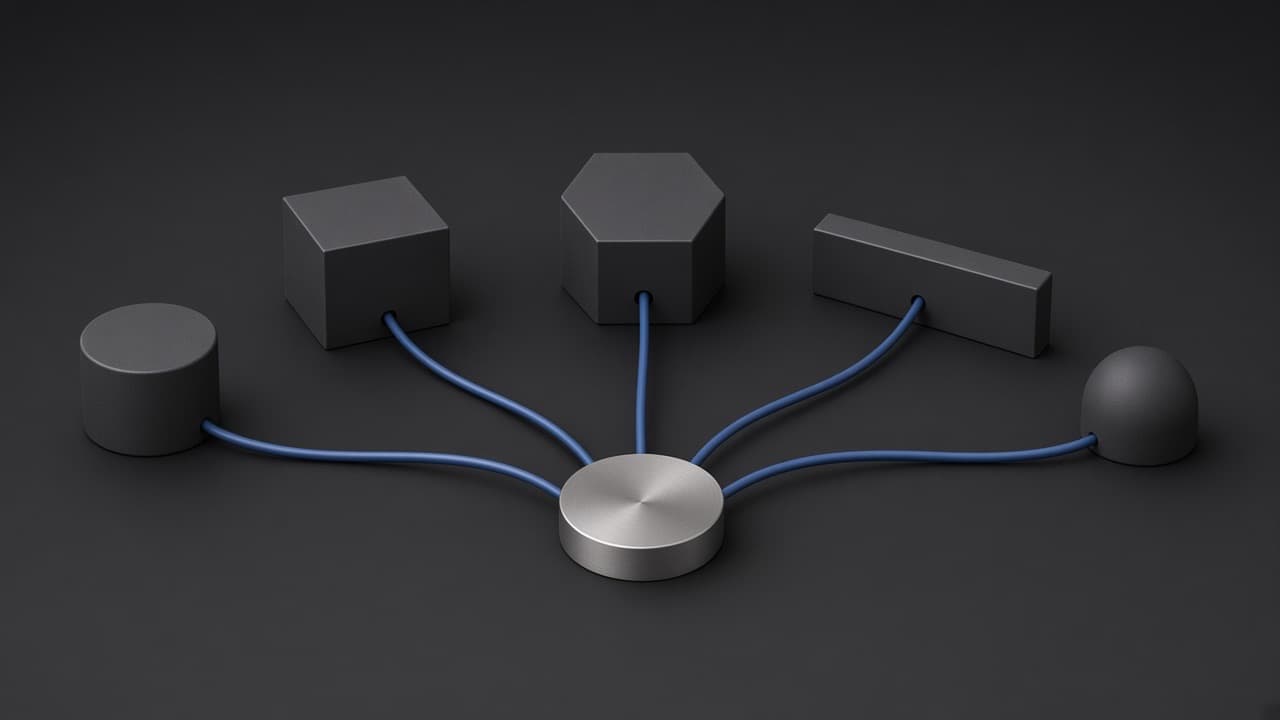
Dina modeller, verktyg och data förblir dina. Agenterna fortsätter att nå simulatorer, analyskod, databaser och instrument via sina egna anslutningar. MS Duplex lär sig av de utfall och expertkorrigeringar som ditt team väljer att fånga, och dina regler avgör vad som delas mellan en forskare, ett team och organisationen. Inget av det delas med något annat företag.
Säg att en forskare eller ingenjör korrigerar en agents rangordning av kandidater eftersom metoden den använde fallerar bortom en känd driftgräns, och registrerar varför. Två dagar senare stöter en kollegas agent, på en annan modell, på ett närliggande fall. MS Duplex hämtar korrigeringen med dess källa och visar vilket antagande som har ändrats. Ingen behövde lägga till en rad i en anteckningsfil eller förklara gränsen en gång till.
Ett inlärningslager för alla områden
MS Duplex är MatterSpaces inlärningslager för alla typer av vetenskapligt och tekniskt arbete. Det den lär sig av är gemensamt för forskning inom alla områden: metoder, beslut, de villkor ett resultat gäller under och de utfall som följde. Varje teams erfarenhet förblir dess egen, i dess egna lager och under dess egna regler.
Så kommer du igång: en pilot på ditt eget arbete
Det rättvisa testet av en AI som påstår sig lära sig är det arbete som ditt team gör om och om igen. En pilot körs på dina egna arbetsflöden, bredvid din nuvarande konfiguration, och dina experter är domare.
- Välj arbetetVälj återkommande forskningsarbetsflöden där beslut upprepas och en felaktig eller onödig körning är dyr: att rekommendera inställningar för nästa körning, rangordna kandidater, granska analyser.
- Kom överens om måttetBestäm det med dina experter innan något körs: kostnaden för varje godkänt, reproducerbart resultat, och den experttid det kräver.
- Kör sida vid sidaSamma modell, verktyg, data och budget, med och utan MS Duplex, och med en styrd anslutning där det passar.
- Bedöm blintDina experter poängsätter resultaten utan att veta vilken uppsättning som gav dem.
Var MS Duplex körs och hur dina data hanteras kommer vi överens om med dina säkerhets- och dataansvariga från första samtalet. Erfarenheten som en pilot bygger upp tillhör din organisation, med varje lärdom och dess källa registrerade så att ditt team kan granska, korrigera eller ta bort dem.
Vanliga frågor
Ändrar MS Duplex vår modell?
Den lämnar modellens vikter som de är. MS Duplex lär sig bredvid modellen, och det är därför en lärdom är redo från och med nästa begäran, därför en enskild lärdom kan korrigeras för sig och därför erfarenheten följer med när du byter modell.
Vad lär den sig av?
Från de utfall och expertkorrigeringar som ditt team väljer att fånga upp: ett test som klarats, en mätning, en godkänd slutsats, en korrigering med sitt skäl. Varje lärdom behåller sin källa och de förhållanden den gäller under.
Är MS Duplex knuten till ett enda vetenskapligt område?
Nej. Det fungerar inom alla områden där ett team forskar eller utvecklar med AI.
Vem äger det den lär sig?
Din organisation. Erfarenheten finns i ett arkiv som din organisation äger, styrs av dina regler och delas inte med något annat företag. Ditt team kan inspektera vilken lärdom som helst, korrigera den, ta bort den eller återställa den.


Byggt av MatterSpace
MatterSpace bygger MS Duplex för forskare, vetenskapare och ingenjörer inom alla fält, så att den AI de redan använder lär sig av varje resultat de bekräftar.





